JS 变量存储?栈 & 堆?NONONO!
“原始类型存在栈里,对象存在堆里”——背了这么多年的结论,真能解释闭包吗?先把口诀放到一边,顺着变量的生命周期重新看看 JavaScript 内存。
前言
这次的 why what or how 主题:JavaScript 变量存储。
无论哪门语言,变量都是组成程序的基础。变量可以绑定数字、对象;在 JavaScript 中,函数同样可以作为值被变量绑定。
那么如此重要的变量,在 JavaScript 中究竟是如何进行存储的?
栈 & 堆 ?
栈(Stack)又名堆栈,它是一种运算受限的线性表。限定仅在表尾进行插入和删除操作的线性表。在百度上搜索 JavaScript 变量存储,能看到很多文章,无外乎一个结论:
对于原始类型,数据本身是存在栈内,对于对象类型,在栈中存的只是一个堆内地址的引用。
但是,我突然想到一个问题:如果说原始类型存在栈中,那么 JavaScript 中的闭包是如何实现的?
当然想要深究这个问题,有必要先把栈(Stack)和堆(Heap)给说说清楚。
那好,先说说栈。
栈
栈是内存中一块用于存储局部变量和函数参数的线性结构,遵循着先进后出的原则。数据只能顺序的入栈,顺序的出栈。当然,栈只是内存中一片连续区域一种形式化的描述,数据入栈和出栈的操作仅仅是栈指针在内存地址上的上下移动而已。如下图所示(以 C 语言为例):
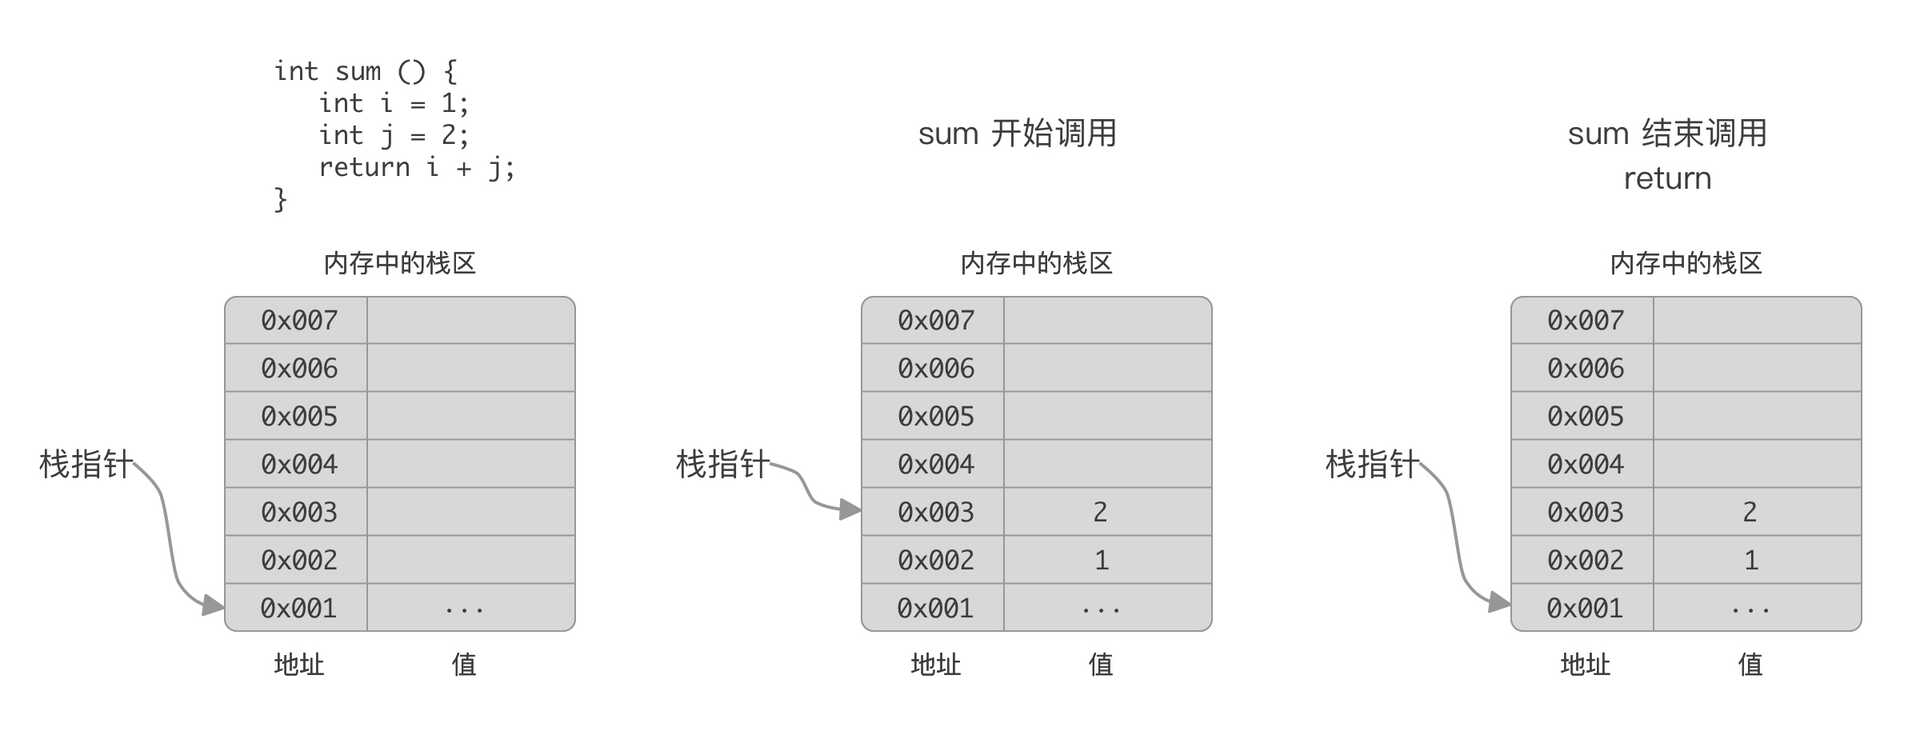
如图所示,栈指针刚开始指向内存中 0x001 的位置,接着 sum 函数开始调用,由于声明了两个变量,往栈中存放了两个数值,栈指针也对应开始移动,当 sum 函数调用结束时,仅仅是把栈指针往下移动而已,并不是真正的数据弹出,数据还在,只不过下次赋值时会被覆盖。
挺简单的不是么,但需要注明一点的是:内存中栈区的数据,在函数调用结束后,就会自动的出栈,不需要程序进行操作,由程序运行时或函数调用机制自动完成,换句话说:栈中的变量在函数调用结束后,就会消失。
因此栈的特点:轻量,不需要手动管理,函数调用时创建,调用结束则消失。
堆
堆可以简单的认为是一大块内存空间,就像一个篮子,你往里面放什么都没关系,但是篮子是私人物品,操作系统并不会管你的篮子里都放了什么,也不会主动去清理你的篮子,因此在 C 语言中,堆中内容是需要程序员手动清理的,否则就会出现内存泄漏;如果持续泄漏,最终还可能耗尽可用内存。
为了解决堆内存的管理问题,一些语言的运行时(如 Java)提供了 GC(Garbage Collection,垃圾回收)机制,用于协助程序管理内存,主动清理堆中已经不再使用的数据。
既然堆是一个大大的篮子,那么在栈中存储不了的数据(比如一个对象),就会被存储在堆中,栈中就仅仅保留一个对该数据的引用(也就是该块数据的首地址)。
问题!
OK 栈和堆内容如上,现在我们再来看看大家的结论:
对于原始类型,数据本身是存在栈内,对于对象类型,在栈中存的只是一个堆内地址的引用。
感觉很符合逻辑啊,按照定义基础类型存在栈中,对象存在堆中,没毛病啊!
但是,请大家思考一个问题:
既然栈中数据在函数执行结束后就会被销毁,那么 JavaScript 中函数闭包该如何实现,先简单来个闭包:
function count () {
    let num = -1;
    return function () {
        num++;
        return num;
    }
}

let numCount = count();
numCount();
// 0
numCount();
// 1
按照结论,num 变量在调用 count 函数时创建,在 return 时从栈中弹出。
既然是这样的逻辑,那么调用 numCount 函数如何得出 0 呢?num 在函数 return 时已经在内存中被销毁了啊!
因此,在本例中 JavaScript 的基础类型并不保存在栈中,而应该保存在堆中,供 numCount 函数使用。
那么网上大家的结论就是错的了?非也!接下来谈谈我对 JavaScript 变量存储的理解。
抛开栈
既然在 JavaScript 中有闭包的问题,抛开栈(Stack),仅用堆能否实现变量存储?我们来看一个特殊的例子:
function test () {
    let num = 1;
    let string = 'string';
    let bool = true;
    let obj = {
        attr1: 1,
        attr2: 'string',
        attr3: true,
        attr4: 'other'
    }
    return function log() {
        console.log(num, string, bool, obj);
    }
}
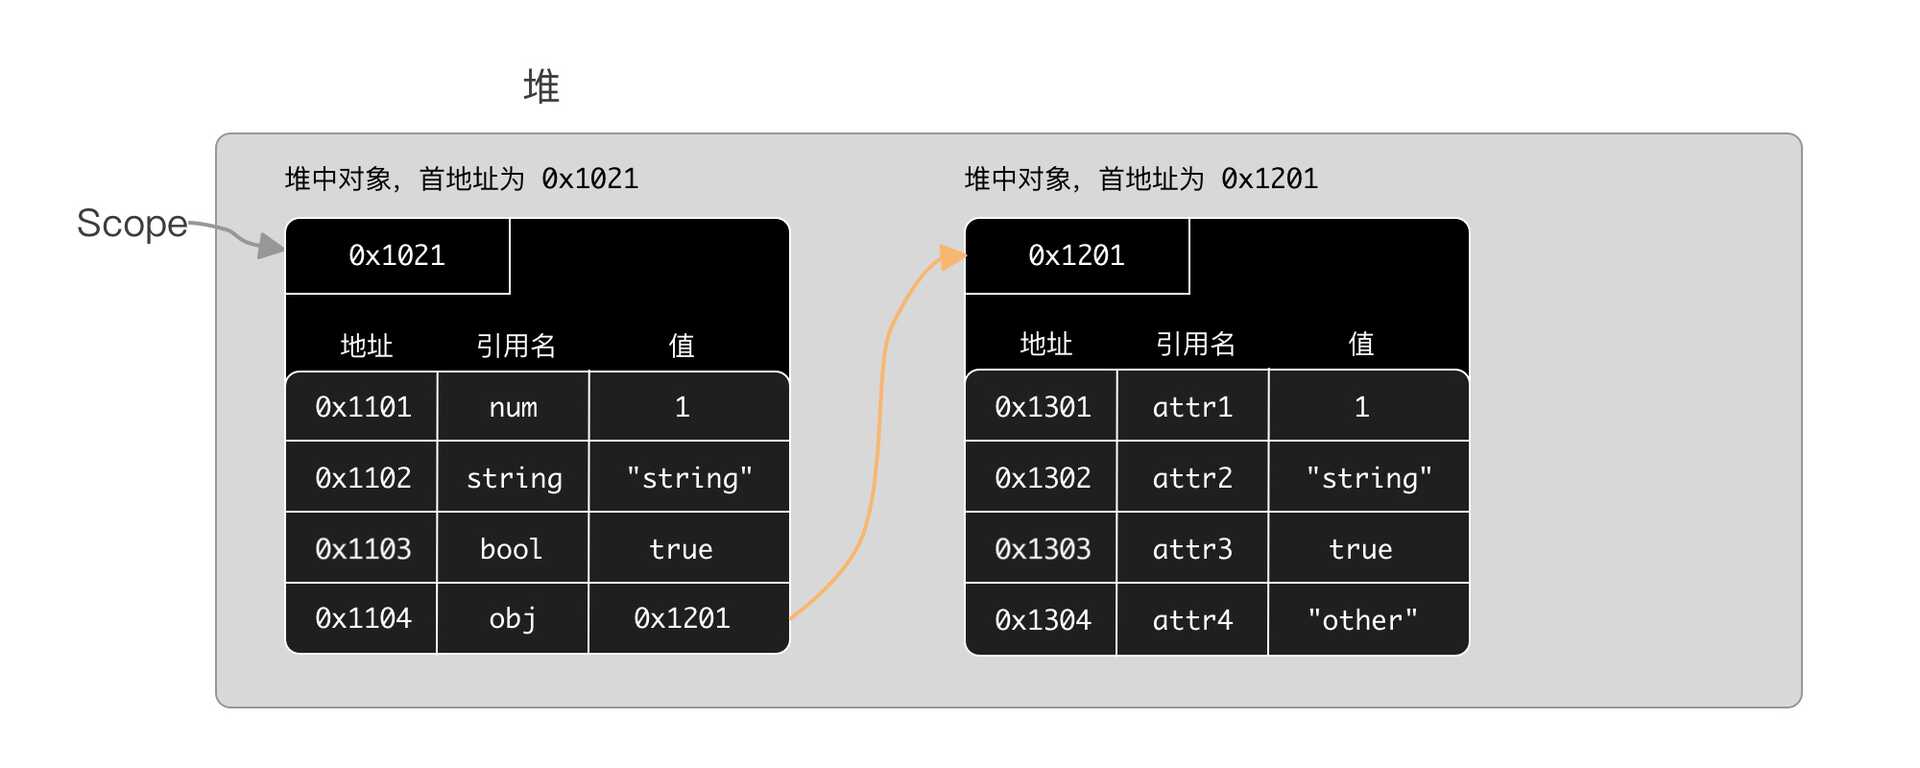
伴随着 test 的调用,为了保证变量不被销毁,在堆中先生成一个对象就叫 Scope 吧,把变量作为 Scope 的属性给存起来。堆中的数据结构大致如下所示:
那么,这样就能解决闭包的问题了吗?
当然可以,由于 Scope 对象存储在堆中,因此返回的 log 函数完全可以访问这个 Scope 对象。下图是该段代码在 Chrome 中的执行效果:
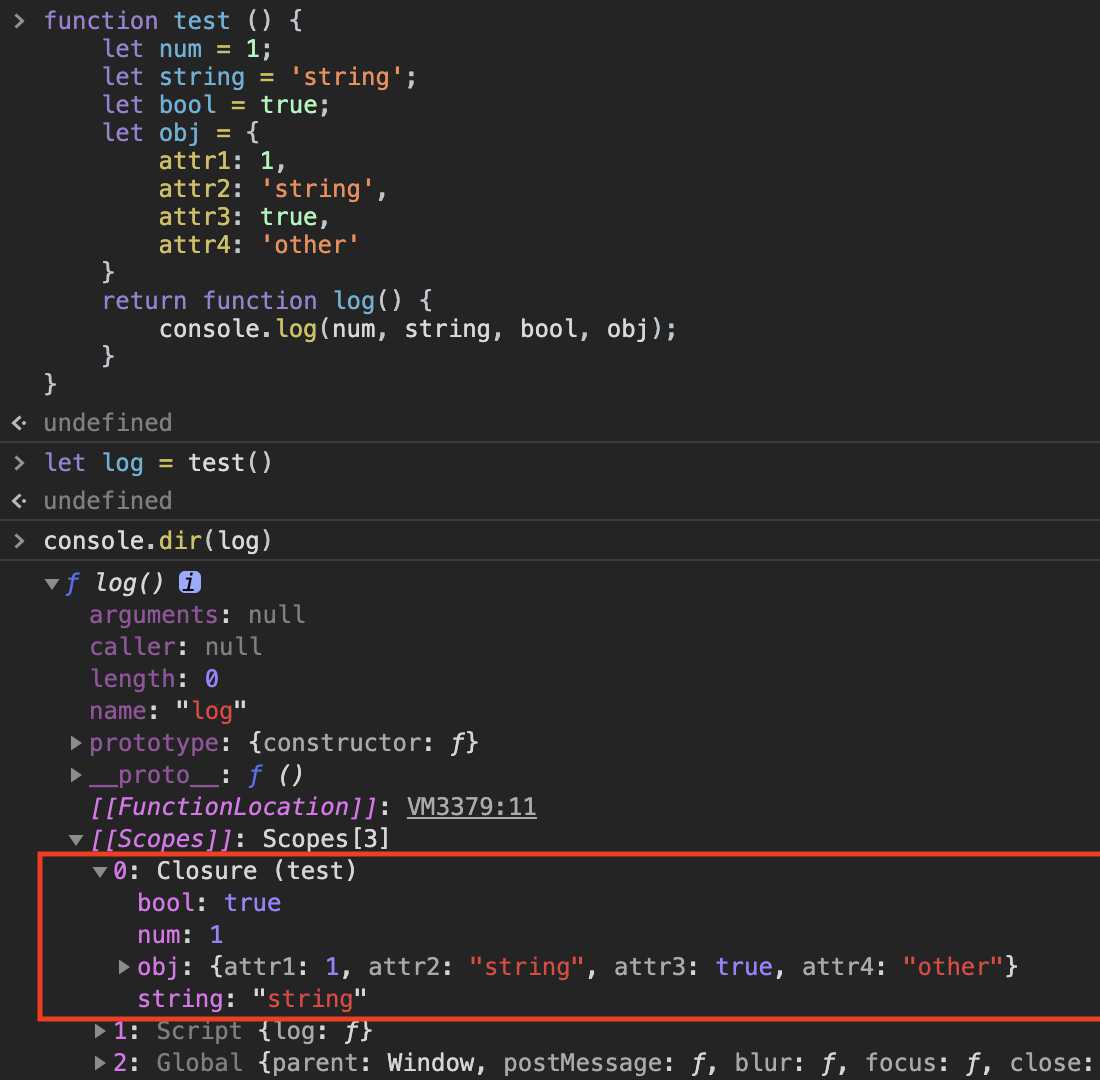
红框部分与上述一致,同时也反映出之前提及的问题:例子中 JavaScript 的变量并没有存在栈中,而是在堆里,用一个特殊的对象(Scope)保存。
那么在 JavaScript 中,变量到底是如何进行存储的?这和变量的类型直接挂钩,接下来就谈谈在 JavaScript 中变量的类型。
三种类型
在 JavaScript 中,变量分为三种类型:
- 局部变量
- 被捕获变量
- 全局变量
局部变量
局部变量很好理解:在函数中声明,且没有被任何内部函数(或类)引用的变量。下面代码中的 local* 都是局部变量。
function test () {
    let local1 = 1;
    var local2 = 'str';
    const local3 = true;
    let local4 = {a: 1};
    return;
}
被捕获变量
被捕获变量就是局部变量的反面:在函数中声明,且被内部函数(或类)引用的变量。是否被捕获是引擎在解析期就能确定的:只要内部函数引用了该变量,外层就需要为它准备 Scope,哪怕这个内部函数从未被调用。下面代码中的 catch* 都是被捕获变量。
function test1 () {
    let catch1 = 1;
    var catch2 = 'str';
    const catch3 = true;
    let catch4 = {a: 1};
    return function () {
        console.log(catch1, catch2, catch3, catch4)
    }
}

function test2 () {
    let catch1 = 1;
    let catch2 = 'str';
    let catch3 = true;
    var catch4 = {a: 1};
    return class {
        constructor(){
            console.log(catch1, catch2, catch3, catch4)
        }
    }
}

console.dir(test1())
console.dir(test2())
复制代码到 Chrome 即可查看输出对象下的 [[Scopes]] 下有对应的 Scope。
全局变量
不同运行环境提供了不同的全局对象:浏览器中通常是 window,Node.js 中是 global,现代 JavaScript 也可以通过 globalThis 统一访问当前环境的全局对象。全局环境会位于函数作用域链的最外层,也就是上述函数 [[Scopes]] 中的最后一层。
以下只讨论浏览器传统脚本中的情况。ES Module 拥有独立的模块作用域;Node.js 的 CommonJS 模块也会封装自己的顶层作用域,它们的顶层变量都不会自动成为全局对象的属性。
全局变量需要特别注意一点:var 和 let/const 的区别。
var
在浏览器传统脚本中,顶层 var 声明会在全局对象 window 上创建对应属性。
var testVar = 1;

console.log(window.testVar); // 1
let / const
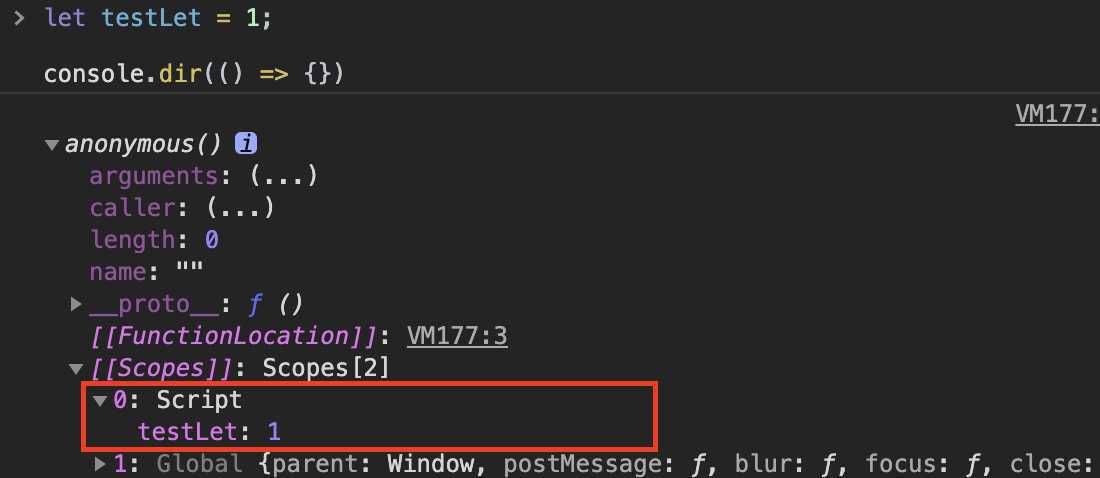
浏览器传统脚本中的顶层 let/const 声明不会在 window 上创建同名属性,而是保存在全局词法环境中(可以用类似 Scope 的模型来理解)。
let testLet = 1;

console.dir(() => {})
复制到 Chrome 有以下结果:
两种方式
那么变量的类型确定了,如何进行存储呢?有两种:
- 栈(
Stack) - 堆(
Heap)
相信看到这里,大家心里应该都有个大概了:
- 局部变量的生命周期与函数调用一致,可以用栈来管理,函数返回后随栈帧一起释放。
- 被捕获变量和全局变量需要比单次函数调用活得更久,只能放在堆中:被捕获变量住在
Scope里,全局变量住在全局对象或全局词法环境中。
但要记住一点:JavaScript 规范并没有规定变量必须存在哪里,栈和堆只是引擎的实现手段。即使是局部变量,也不保证一定在栈上——优化后的代码里,它可能只活在寄存器中,甚至被完全消除。所以更准确的说法是:引擎按变量的生命周期决定存储位置,被捕获的变量通常会进入堆中的 Scope。
那么引擎如何区分局部变量与被捕获变量呢?在解析期判断它是否被内部函数引用即可!那么你一定想问,Chrome 的 V8 能否判断出?从结果看,可以。
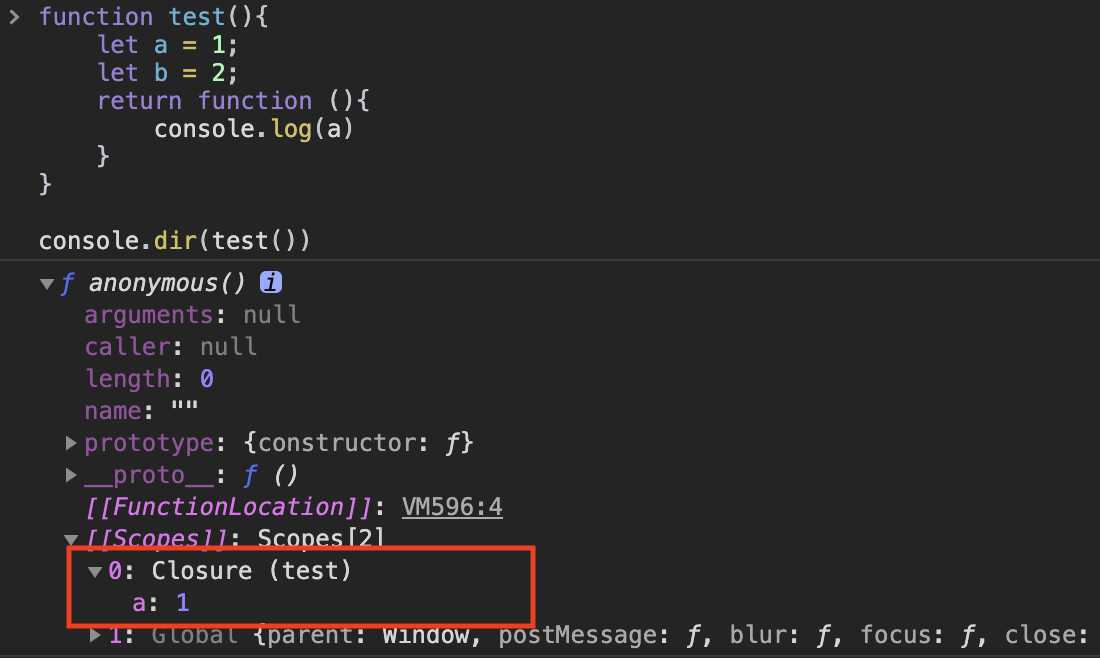
红框内仅有变量 a,而变量 b 已经消失不见了。由于 Firefox 打印不出 [[Scopes]] 属性,因此,笔者判断不出。当然,如果有大佬能深入了解并补充的话,感激不尽。
好,了解了如何存储,接下来我们看看如何赋值。
变量赋值
其实不论变量最终由引擎放在栈、堆还是寄存器中,都可以把它理解成一个“变量名 → 槽位值”的绑定。基础类型的槽位直接保存值;对象类型的槽位保存对象引用,下文为了方便会把引用画成地址:
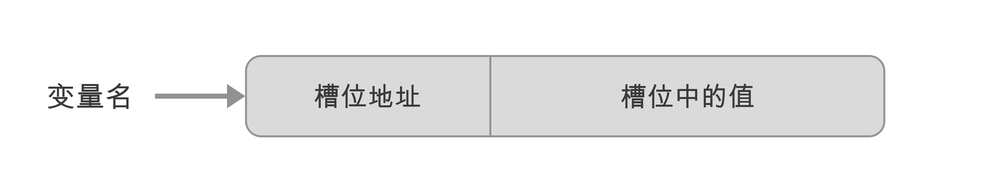
那好现在我们来看看赋值,根据 = 号右边变量的类型分为两种方式:
将值赋予变量
何为值?值就是一声明就可以确定的东西,比如 1、"string"、true、{a: 1},都是值。其中基础类型的值一旦创建就无法原地改变,想要新值只能整体替换;对象的值其实也是声明即确定的,这个问题先留着,等下再解释。
假设现在有如下代码:
let foo = 1;
JavaScript 声明了一个变量 foo,且让它的值为 1,内存中就会发生如下变化
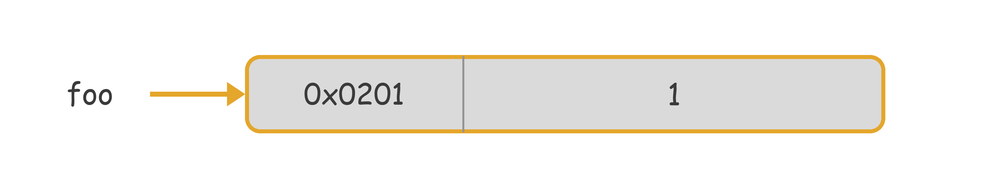
如果现在又声明了一个 bar 变量:
let bar = 2;
那么内存中就会变成这样:
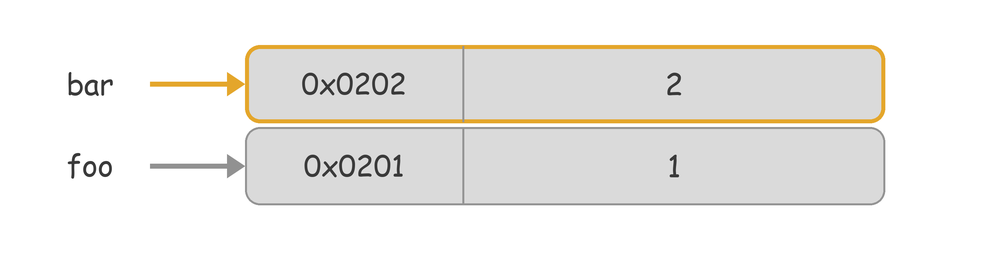
现在回顾下刚刚留下的问题:对象的值其实也是声明即确定的,是什么意思?
比如有以下代码:
let obj = {
    foo: 1,
    bar: 2
}
内存模型如下:
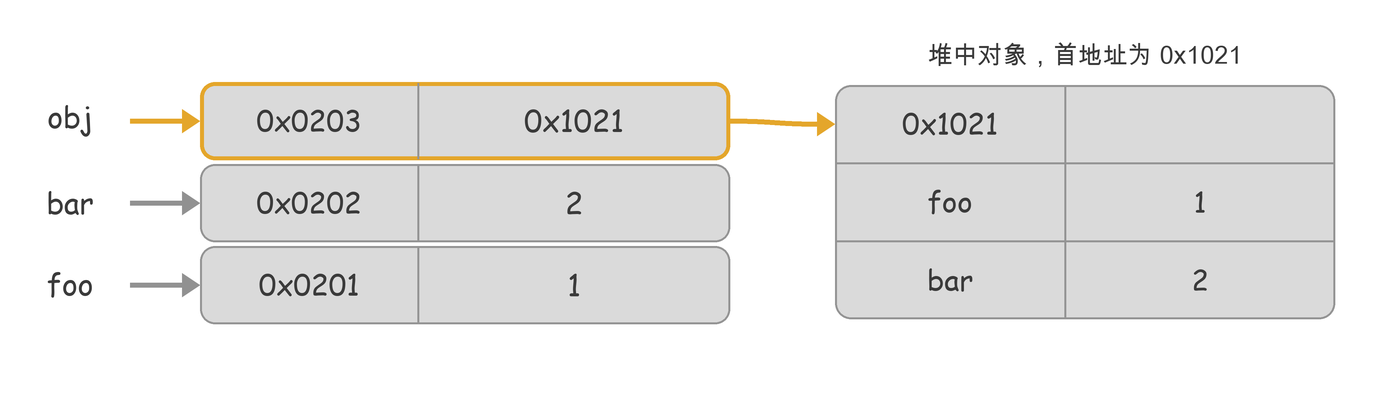
通过该图,我们可以知道,obj 的槽位保存的是对象区域的地址值。只要不给 obj 重新赋值,这个槽位就一直保存 0x1021,obj 也就始终引用同一个对象。稍有不同的是对象区域的内部:如果执行 obj.foo = 'foo',修改的是 0x1021 所在区域的内容,这个操作不触碰 obj 的槽位,任何持有同一地址的变量都能看到这个改动。所以这里其实有两种“变”:
- 改槽位值:给变量重新赋值,用新值覆盖变量自己的槽位;
- 改对象内部:修改对象属性,变量槽位保持不变。
分清这两种“变”,“不变”与“能变”就不矛盾了:对象的身份不会因为属性变化而改变;变量保存的引用则可以通过重新赋值被替换。
将变量赋予变量
何为变量?在上述过程中的 foo、bar、obj 都是变量。变量是名称与槽位之间的绑定,槽位会保存当前值。
那么如果我将一个变量的值赋值给另一变量,会发生什么?
let x = foo;
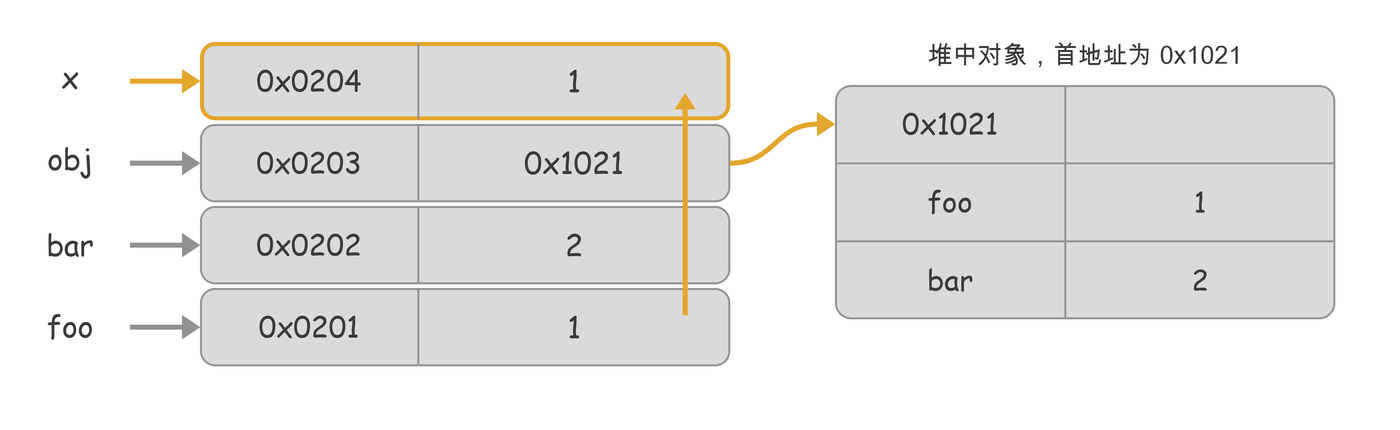
如上图所示,赋值会读取 foo 槽位中的值 1,再把它复制到 x 自己的槽位。foo 与 x 的值虽然相同,但两个变量彼此独立,之后修改其中一个不会影响另一个。
OK 赋值到此为止,接下来是修改。
变量修改
与变量赋值一样,变量的修改也需要根据 = 号右边变量的类型分为两种方式:
修改为值
foo = 'foo';
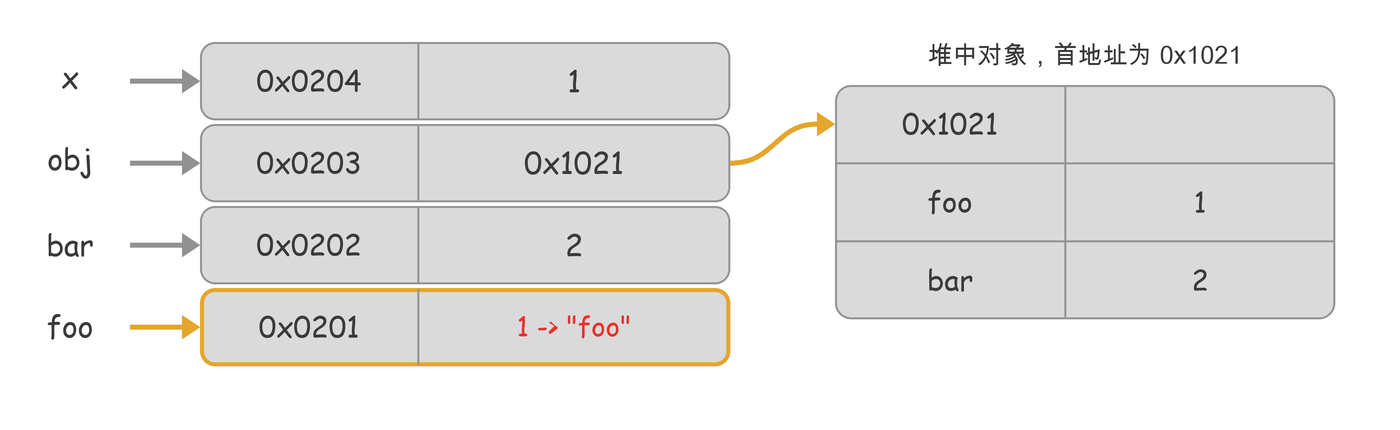
如上图所示,'foo' 会覆盖 foo 槽位中原来的 1。这个操作只修改 foo 自己的槽位,x 仍然保存先前复制过去的 1。
修改为变量
foo = bar;
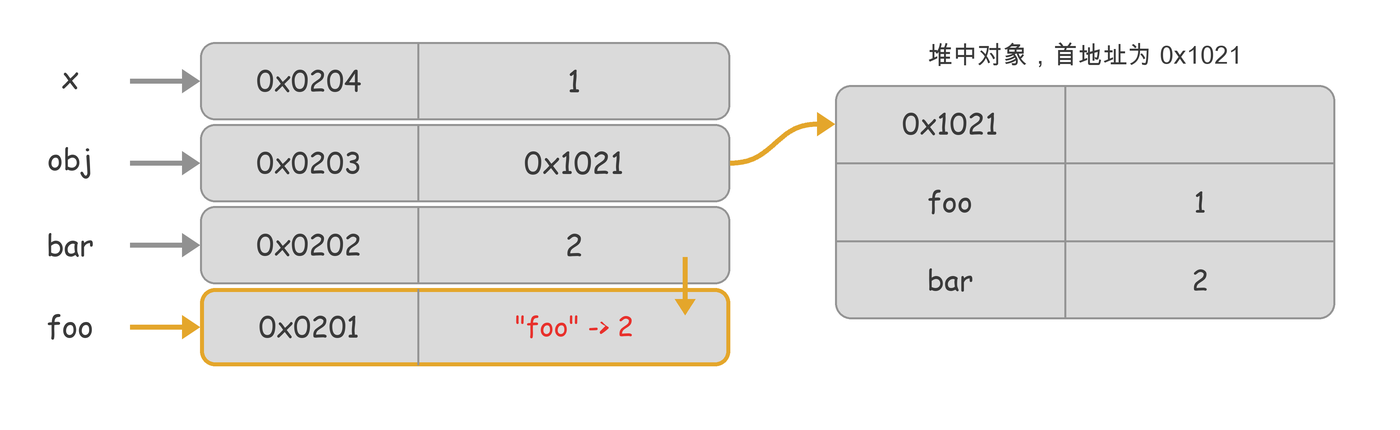
如上图所示,赋值会读取 bar 槽位中的值 2,再用它覆盖 foo 槽位中的原值。修改完成后,foo 与 bar 都保存 2,但它们仍是两个独立的变量。
const 的工作机制
const 为 ES6 新出的变量声明的一种方式,被 const 修饰的变量不能重新赋值。
对应到 JavaScript 的变量存储图中,就是变量槽位初始化后不能再写入新值。前面说过,重新赋值会覆盖槽位内容,const 做的就是禁止这次覆盖。
比如说以下代码:
const foo = 'foo';
foo = 'bar'; // Error
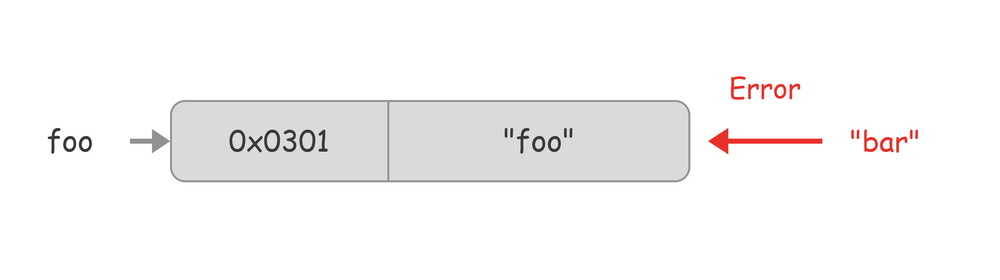
如上图所示,给 foo 写入 'bar' 的操作会被拒绝,槽位仍然保存原来的 'foo'。
那好现在是否能解决你对下面代码的困惑:
const obj = {
    foo: 1,
    bar: 2
};
obj.foo = 2;
obj 槽位保存的地址没有变化,变化的是该地址对应对象的内部属性。如下图所示:
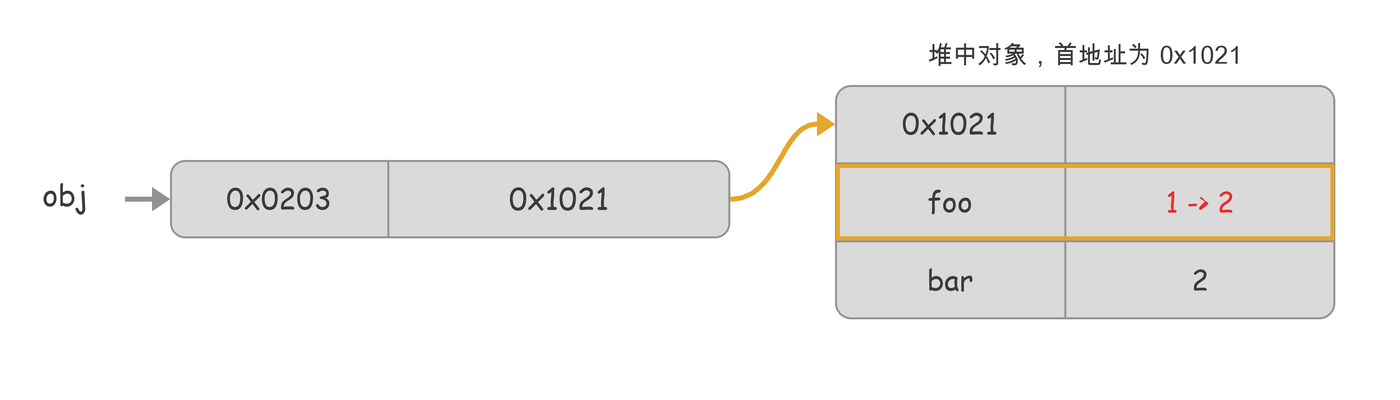
对象的修改
OK 进入一个面试时极度容易问到的问题:
let obj1 = {
    foo: 'foo',
    bar: 'bar'
}

let obj2 = obj1;
let obj3 = {
    foo: 'foo',
    bar: 'bar'
}

console.log(obj1 === obj2);
console.log(obj1 === obj3);

obj2.foo = 'foofoo';

console.log(obj1.foo === 'foofoo');
请依次说出 console 的结果。
我们不讨论结果,先看看内存中的结构。
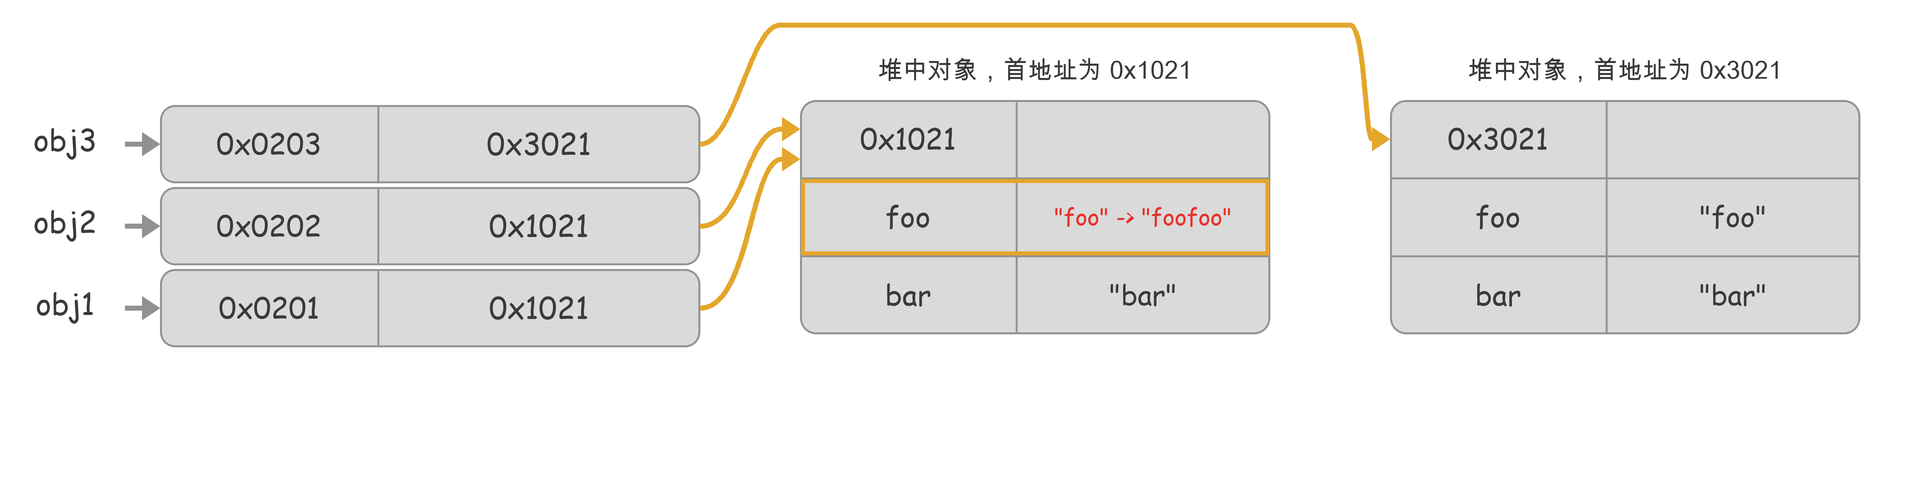
=== 比较的正是槽位里的内容:基础类型比较值是否相等,对象比较地址是否相同——地址相同,才是同一个对象;地址不同,就只是长得一样的两个对象。至于第三个输出,就看 obj2 改的那个区域,obj1 是不是也在看了。
所以你现在知道答案了吗?
总结
在 JavaScript 中,变量并非完完全全地存在栈中。普通调用栈只能管理生命周期与函数调用一致的局部变量;当变量逃逸、被闭包捕获时,运行时还需要使用生命周期独立于当前栈帧的 Scope 保存它。因此,只用“原始类型存在栈中、对象类型存在堆中”来概括 JavaScript 的变量存储并不准确。希望大家能通过本文真正理解 JavaScript 中变量与内存的关系。
按照惯例,提几个问题:
JavaScript变量的类型都有哪些?JavaScript对于基础类型和对象类型是如何存储的?